Showing Posts From
Javascript
- 29 May, 2026
문자열 +=는 정말 O(N²)일까? V8의 ConsString 들여다보기
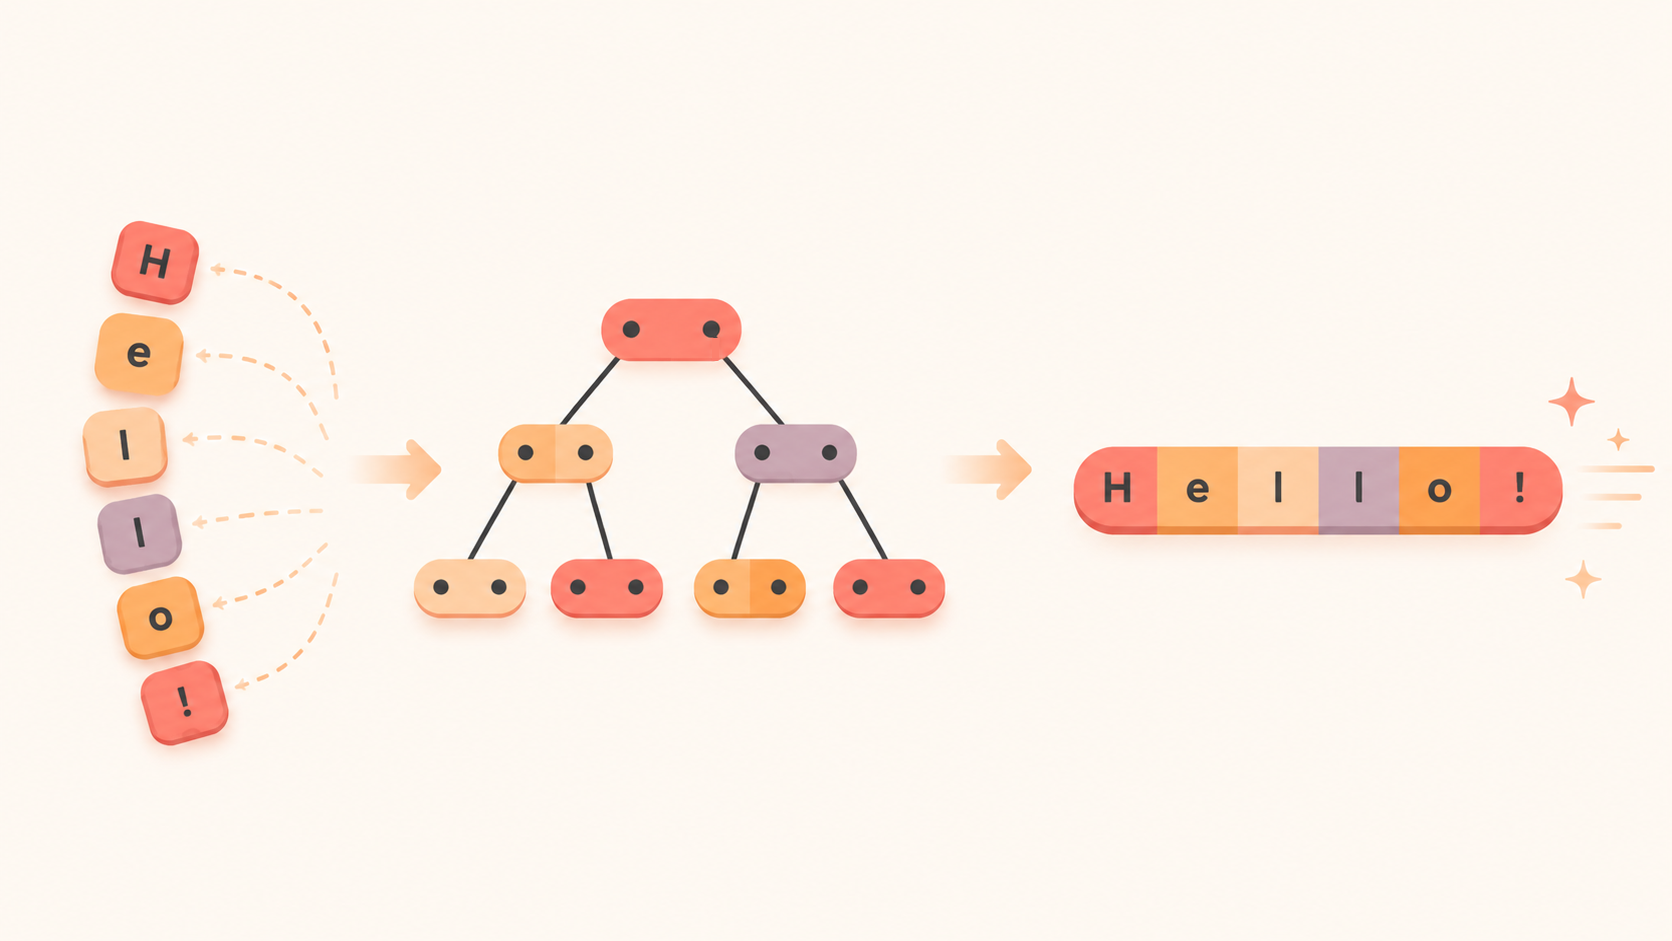
문자열이 여러 개 있을 때 모든 문자열들을 합쳐야 한다. 그럴 때 우리는 이렇게 코드를 짤 수 있다. function joinWords(words) { let sentence = ""; for (const word of words) { sentence += word; } return sentence; }JavaScript에 익숙하다면 join 메서드를 사용할 수 있다. function joinWords(words) { return words.join(""); }첫 번째 방식을 보면 "문자열은 불변(immutable)이라서, += 는 매번 새 문자열을 통째로 복사하기 때문에 N개를 이어 붙이면 O(N²)이 된다. 그렇기 때문에 Array.prototype.join()을 써야 한다." 라는 생각이 우선 든다. 문자열은 실제로 불변이고, sentence += word 는 기존 문자열을 고치는 게 아니라 기존 내용과 새 단어를 합친 새 문자열을 만들어 대입한다. 이론적으로는 단계마다 누적 길이만큼 복사가 일어나니 O(N²)이 맞다. 그런데 실제로 시간을 측정해보면 이야기가 달라진다. 그 이유를 만드는 V8 내부 장치인 ConsString을 들여다보고, 직접 만든 모델 코드와 실제 벤치마크로 확인해보려고 한다. ConsString - 일단 합치지 않고 미룬다. V8(Chrome과 Node.js의 JavaScript 엔진)은 두 문자열을 연결할 때 곧바로 문자를 복사하지 않는다. 대신 "이 둘이 이어져 있다"는 사실만 기록한 노드를 만든다. 이 노드가 ConsString(concatenated string) 이다. 여러 번 이어붙이면 이 노드들이 트리 구조로 쌓인다. 실제 문자 복사는 그 문자열의 내용이 정말로 필요해지는 순간까지 미뤄진다. 이것을 지연 평가(lazy evaluation)라고 부른다. 원리를 코드로 확인해보기 위해, ConsString의 핵심 동작만 흉내 낸 모델을 만들어보았다. (실제 V8 코드는 아니다. 어디까지나 멘탈 모델을 코드로 표현한 것이다.) // 평탄화 횟수 let flattenCount = 0;class ConsString { constructor(left, right) { // 즉시 합치지 않고 두 조각의 참조만 들고 있는다. => O(1) this.left = left; this.right = right; this.length = left.length + right.length; this._flat = null; } concat(other) { return new ConsString(this, other); } flatten() { if (this._flat !== null) return this._flat; flattenCount++; const l = this.left instanceof ConsString ? this.left.flatten() : this.left; const r = this.right instanceof ConsString ? this.right.flatten() : this.right; return (this._flat = l + r); } toString() { return this.flatten(); } }let s = ""; for (const w of ["hello", "my", "name", "dohun"]) { s = s === "" ? w : new ConsString(s, w); }console.log(flattenCount); // 0 console.log(s.toString()); // "hellomynamedohun" console.log(flattenCount); // 2 s.toString(); console.log(flattenCount); // 2연결을 끝낸 시점의 평탄화 횟수는 0이다. 노드만 쌓았을 뿐 실제 합치기는 한 번도 일어나지 않았다. 이게 연결 자체는 O(1)의 시간복잡도를 가지게 된다. toString() 으로 내용을 요구하는 순간 비로소 트리가 펼쳐지고, 한 번 펼친 결과는 캐싱되어 다음 요구부터는 다시 펼쳐지지 않는다. 결과적으로 l + r 도 복사가 아닌가? flatten() 안의 this._flat = l + r은 분명히 문자열 연결이고, 내부적으로 문자를 복사해 새 문자열을 만든다. 결과적으로 ConsString이 복사를 없앤 게 아니지 않은가? 맞다. ConsString이 없애는 건 복사 자체가 아니라 중간 단계마다 반복되는 복사이다. 예시로 [a, b, c, d]가 합쳐지는 과정을 보자. s = a (복사 없음) s = s + b → "a" + "b", 길이 2 복사 s = s + c → "ab" + "c", 길이 3 복사 s = s + d → "abc" + "d", 길이 4 복사매 단계에서 그때까지 누적된 전체를 다시 복사한다. 복사량이 쌓여 O(N²)이 된다. 같은 앞부분을 거듭 복사하는 것이 중요한 내용이다. 하지만 ConsString은 연결 단계에서 단 한번 마지막에 복사를 해서 합쳐질 뿐 매번 누적해서 복사하지 않는다. 그렇기에 O(N)으로 줄어든다. 언제 평탄화가 되는가? ConsString은 두 조각이 이어져 있다라는 지연된 표현이다. 임의 위치의 문자에 실제로 접근해야 하는 연산이 들어오면 그 시점에 트리를 하나의 연속된 버퍼로 펼친다. 대표적인 트리거는 다음과 같다.인덱싱, 문자 접근: str[i], charAt, CharCodeAt 다수의 내장 메서드: 정규식 매칭, indexOf, slice 등 연속 버퍼가 필요한 연산 엔진 외부로 데이터를 넘길 때: console.log 출력, JSON 직렬화 등한 번 펼쳐지면 결과가 보관되어 이후 접근은 빠르다. 모델과 실제 V8의 차이 위 모델은 원리를 보여줄 뿐, 실제 V8과는 다음 점에서 다르다.V8은 결과 문자열 길이가 약 13자 미만이면 ConsString을 만들지 않고 즉시 복사한다. 노드 객체 자체의 메모리 오버헤드가 짧은 문자열에는 손해이기 때문이다. 실제 평탄화는 위 모델처럼 재귀로 + 하는 대신, 총 길이만큼 버퍼를 미리 할당해 한 번에 채운다. 캐싱도 별도 프로퍼티가 아니라 노드 자체를 평탄화된 표현으로 교체하는 방식이다.성능 측정 세 가지 방식을 여러 N에서 비교했다.+= 누적 배열을 join("") 빈 배열에 push 한 뒤 join("")Node v22.22.2, 각 케이스를 20회 워밍업 후 11회 측정한 중앙값(ms)이다. 단어는 2~4자 길이를 사용했다. V8은 처음엔 코드를 느린 인터프리터로 실행하다가, 충분히 반복되면 최적화 컴파일러(JIT)가 빠른 기계어로 다시 컴파일한다. 그래서 처음 몇 번은 느리다. 측정 전에 함수를 미리 여러 번 돌려 이 최적화를 끝내 두는 것이 워밍업이다. 안 하면 "데워지기 전"의 느린 상태를 측정하게 된다. 짧은 단어 (2~4자)N (단어 수) += 배열 join() push + join()1,000 0.01 0.01 0.0210,000 0.06 0.16 0.2150,000 0.31 1.16 1.80100,000 0.62 2.6 4.1500,000 3.85 16.5 25.91,000,000 33.5 34.8 565,000,000 329 231 597긴 단어 (~31자)N (단어 수) += 배열 join() push + join()10,000 0.06 0.4 0.48100,000 0.62 4.0 5.4500,000 3.9 27.4 37.41,000,000 33.4 52.7 76.85,000,000 289 270 579+= 는 O(N²)이 아니다. ConsString이 올바르게 작동하고 있다는 직접적인 증거이다. 소~중 규모에서는 오히려 += 가 빠르다. join() 은 별도 배열을 순회하고 평탄화하는 비용을 치르기 때문이다. 역전은 수백만 단어 규모에서 발생한다. 즉 join()이 빠르다는 건 큰 입력에서 성립한다. 단어가 길수록 역전이 더 늦는다. 긴 단어 500만에서는 둘이 거의 비슷하다. 단어가 길면 다뤄야 할 노드 수는 같은데 복사할 총 바이트가 늘어, join()의 버퍼 선할당 이점이 상대적으로 덜 두드러진다.결론 "문자열은 불변이니 +=는 O(N²), 무조건 join()"이라는 통념은 알고리즘 수업에서는 맞지만, 실제 V8 런타임에서는 ConsString 덕분에 둘 다 O(N)에 가깝게 동작한다. 그리고 측정해 보면 일상적 규모에서는 오히려 +=가 빠른 경우가 많다. 실무적으로 정리하면.대부분의 경우(수천~수십만 단어) +=로 충분하고, 종종 더 빠르다. 그러니 읽기 쉽고 의도가 분명한 쪽을 고르면 된다. 단어들을 이미 배열로 들고 있다면 words.join("")이 가장 간결하다. 두 방식의 성능이 역전되는 건 수백만 단어 이상의 큰 입력에서다. 그런 규모이거나 메모리 사용량을 예측 가능하게 두고 싶다면 join()이 더 안정적이다. 무엇보다 ConsString의 13자 임계값 같은 내부 동작에 코드를 의존시키지 말 것. 그건 엔진이 알아서 잘하라고 있는 최적화이지, 우리가 기대고 설계할 대상이 아니다.참고V8's ConsString Optimization in JavaScript v8/v8 — src/objects/string.h How we made JSON.stringify more than twice as fast — V8 Blog V8. Working with Strings. Expanding Vocabulary — Frontend Almanac