Latest Posts
Read all posts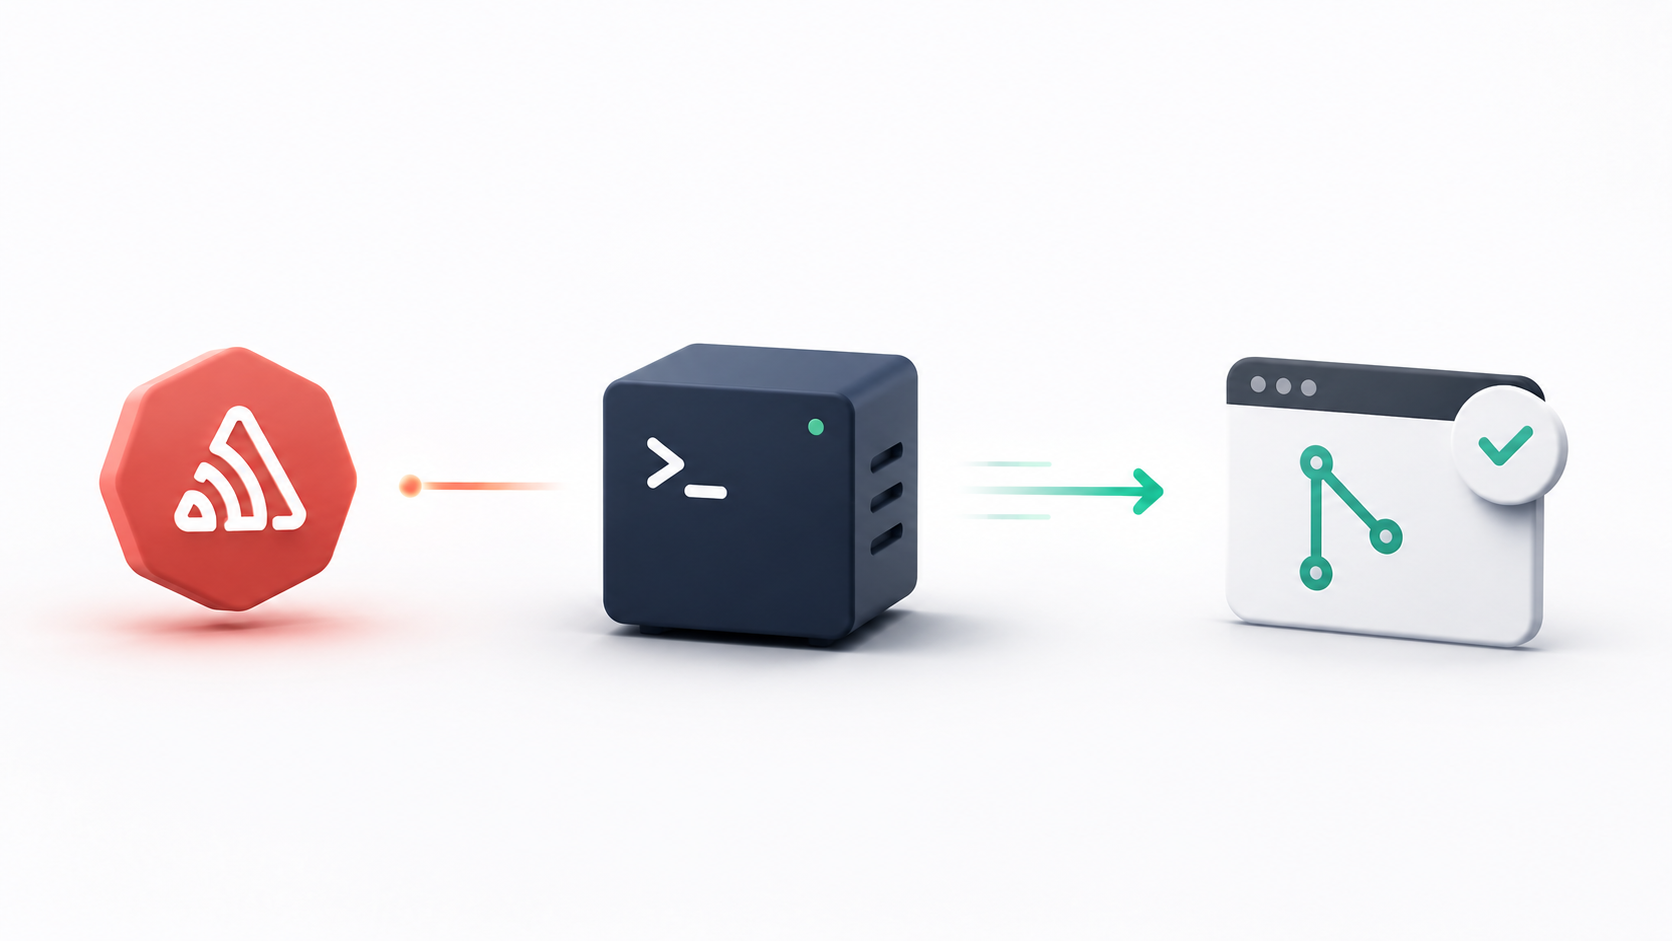
- 19 Jun, 2026
Sentry 에러를 AI가 자동으로 수정하는 파이프라인 설계하기
서비스를 운영하다 보면 Sentry 알림을 받고, 코드를 열고, 스택트레이스를 보고, 원인을 파악하고, 수정하고, PR을 올리는 과정을 반복하게 된다. 이 흐름 자체는 단순하지만 반복적이다. Claude Code가 이 과정을 대신할 수 있지 않을까? 라는 생각으로 설계를 해보았다. 이 글은 Sentry 에러 발생 → 자동 분석 → PR 생성까지 이어지는 파이프라인을 설계하고 구축한 경험을 다룬다. 구현 세부사항보다는 왜 이런 구조를 선택했는지, 각 설계 결정의 과정을 다루고 있다. 기존 흐름: Sentry 알림 → Slack → 사람이 수동으로 수정 자동화를 떠올린 건 결국 기존 흐름이 불편했기 때문이다. 원래 대응 과정은 이랬다. stage 환경에서 프론트엔드 에러가 발생하면 Sentry가 이를 잡아내고, Alert 연동을 통해 Slack 채널(#코인_오류_front_end_stage)로 알림을 보낸다. 채널에는 ReferenceError, TypeError 같은 에러들이 시간순으로 쌓인다.여기까지는 자동이다. 문제는 그다음부터다. 개발자는 Slack 알림을 보고 → Sentry 이슈 페이지로 들어가 → 스택트레이스와 브레드크럼을 읽고 → 원인이 될 만한 소스 파일을 찾고 → 수정하고 → PR을 올린다.위 이슈(ReferenceError: dtrum is not defined)처럼, 한 건을 처리하려면 Sentry 화면에서 스택트레이스(app:///gtm.js:739:429 …), 발생 URL, 환경, 브레드크럼을 일일이 눈으로 훑어야 한다. 흐름 자체는 단순하지만 알림을 받는 일만 자동이고, 그 뒤의 분석과 수정은 전부 사람 몫이다. 그래서 stage처럼 에러가 자주 쌓이는 환경에서는 알림은 빠르게 차오르는데 대응은 계속 밀린다. 이 "Slack 알림 이후의 반복 노동"을 누가 대신할 수 있을까? 그게 이 파이프라인의 출발점이었다. Sentry가 Slack까지 보내주듯, 그 알림을 사람 대신 Claude Code가 받아서 분석하고 PR까지 만들면 되지 않을까 생각이 들었다. 시작 - 복잡한 설계 처음에는 이런 구조로 시작했다. Sentry → Vercel (webhook receiver) → GitHub repository_dispatch → GitHub Actions → Oracle Instance → PR각 단계가 생겨난 데는 나름의 이유가 있었다. Vercel이 webhook receiver가 된 이유. Sentry는 webhook을 보낼 public HTTPS endpoint가 필요하다. 가장 빠른 선택은 Vercel이었다. 배포만 하면 자동으로 HTTPS가 붙고, 서버 관리가 필요 없다. Oracle 인스턴스에 직접 포트를 열고 SSL을 설정하는 것보다 훨씬 빠르게 시작할 수 있었다. GitHub Actions가 끼어든 이유. Vercel이 webhook을 받고 나서 Oracle을 직접 호출하려면 Oracle에도 public endpoint가 있어야 한다. 하지만 Oracle 인스턴스는 외부에 노출돼 있지 않았다. 이 문제를 해결하는 방법으로 역방향 연결 패턴을 선택했다. Vercel이 GitHub에 repository_dispatch 이벤트를 발행하면, Oracle의 GitHub Actions runner가 GitHub를 polling하다가 이벤트를 감지해서 실행하는 구조다. Vercel ──→ GitHub (이벤트 발행) ↑ Oracle ────────── GitHub Actions runner가 pollingOracle이 외부에 노출되지 않아도, GitHub를 중계 채널로 써서 트리거를 받을 수 있었다. 각 단계는 나름의 이유로 추가됐지만, 결과적으로 아무런 비즈니스 로직 없이 데이터를 전달하기만 하는 단계들이 쌓였다. 최종: Oracle 인스턴스 하나로 줄이기 불필요한 중간 단계를 제거하면 답은 명확했다. Sentry → Oracle Instance → PROracle 인스턴스가 webhook을 직접 받아서 Claude Code를 실행하면 된다. Vercel도, GitHub Actions도 필요 없다. 이 구조가 가능한 이유는 단순하다. Claude Code CLI는 결국 로컬(혹은 서버)에서 실행되는 프로세스다. 굳이 GitHub Actions라는 CI 환경을 거칠 이유가 없었다. webhook을 받는 주체와 Claude Code를 실행하는 주체를 하나로 합치자, 중계만 하던 단계들이 통째로 사라졌다. 설계 결정 1: Oracle 인스턴스에 직접 public endpoint 열기 Sentry가 webhook을 보내려면 공개적으로 접근 가능한 HTTPS endpoint가 필요하다. 방법은 두 가지였다. Option A: Oracle 인스턴스에 직접 HTTPS 열기nginx + Let's Encrypt SSL Oracle Security List와 OS 방화벽(nftables)에서 443 포트 오픈 SSL 갱신, 포트 관리 등 직접 운영Option B: Cloudflare Tunnel인스턴스에서 cloudflared 데몬 하나만 실행 포트 오픈, SSL 설정 불필요 Cloudflare 의존성 추가A를 선택한 이유. 외부 서비스 의존성을 추가하지 않으면서 직접 제어할 수 있는 구조가 더 낫다고 판단했다. SSL 갱신은 certbot이 자동으로 처리해주기 때문에 실제 운영 부담은 크지 않다. 설계 결정 2: webhook을 어디까지 믿을 것인가 public endpoint를 열었다는 것은, 그 주소를 아는 누구나 POST 요청을 보낼 수 있다는 뜻이다. 이 요청 하나가 곧바로 Claude Code 프로세스를 띄우고 git push까지 이어지기 때문에, 입력을 검증하는 단계가 생각보다 중요했다. 시크릿을 두 경로로 받기. Sentry의 webhook은 강력한 서명(HMAC) 검증을 강제하지 않는다. 그래서 공유 시크릿 방식을 택했는데, 이걸 헤더(x-webhook-secret)와 쿼리 파라미터(?secret=...) 두 경로 모두에서 받도록 했다. Sentry의 Alert 연동 UI는 버전과 연동 방식에 따라 커스텀 헤더를 못 넣는 경우가 있어서, 헤더가 막히면 URL에 시크릿을 붙이는 쪽으로 우회할 수 있게 한 것이다. 둘 중 하나라도 일치하지 않으면 401을 반환한다. body 읽기에 타임아웃 걸기. 요청 본문을 읽는 단계에 Promise.race로 8초 타임아웃을 걸었다. 외부에 열린 endpoint이다 보니, 느리거나 중간에 끊긴 연결이 핸들러를 무한정 붙잡고 있을 수 있다. 8초를 넘기면 408로 끊어내고 다음 요청을 받을 수 있게 했다. 이렇게 검증 단계를 실패 사유별로 다른 상태 코드(401 인증 실패, 408 수신 지연, 400 JSON 파싱 실패)로 나눠두면, Sentry 쪽 전송 로그만 봐도 어디서 막혔는지 바로 구분된다. 설계 결정 3: Webhook 수신 즉시 응답하기 (fire-and-forget) Sentry는 webhook을 보낸 후 응답을 일정 시간 안에 받지 못하면 실패로 처리한다. Claude Code가 코드를 분석하고 PR을 만들기까지는 수분이 걸릴 수 있다. 이 두 가지는 양립하기 어렵다. 해결책은 fire-and-forget 패턴이다. Sentry webhook 수신 ↓ payload 파싱 및 검증 ↓ Claude Code를 백그라운드 프로세스로 spawn (detached) ↓ 즉시 200 응답 반환 ← Sentry는 여기서 완료로 처리 ↓ (비동기) Claude가 백그라운드에서 분석 → 수정 → PR 생성Node.js에서는 child_process.spawn에 detached: true와 proc.unref()를 조합하면 부모 프로세스와 완전히 분리된 백그라운드 프로세스를 만들 수 있다. 핵심은 핸들러 안에서 runClaudeCode(issue, aiContext)를 await 없이 호출한다는 점이다. spawn만 던져두고 곧장 응답으로 넘어가므로, Claude Code가 몇 분을 돌든 HTTP 응답은 그와 무관하게 즉시 반환된다. 응답에 무엇을 담을 것인가. 즉시 반환하는 200 응답은 "잘 받았다"는 신호 이상의 역할을 하기 어렵다. 그래도 디버깅에 도움이 되도록, 응답 body에 처리에 필요한 최소한의 메타데이터를 실어 보낸다.issueId / eventId — 어떤 이슈를 받았는지 스택트레이스 프레임 개수 — 컨텍스트가 비어 있지 않은지 브레드크럼 존재 여부, top_in_app_frame 추출 성공 여부이렇게 해두면 PR이 만들어지기 한참 전이라도, Sentry 전송 로그에 찍힌 응답만으로 "컨텍스트가 제대로 구성됐는지"를 즉시 확인할 수 있다. 정작 결과물(PR)은 비동기로 만들어지므로, 동기 응답이 줄 수 있는 정보를 최대한 끌어모은 셈이다. 트레이드오프는 있다. Sentry 입장에서는 PR이 실제로 만들어졌는지 알 수 없고, Claude Code 실패 여부도 별도로 모니터링해야 한다. 하지만 "일단 받고 처리한다"는 단순함이 더 중요했다. 설계 결정 4: AI에게 전달할 컨텍스트 설계 Claude Code가 에러를 제대로 분석하려면 Sentry의 raw payload를 그대로 넘기는 것보다 구조화된 컨텍스트를 만들어서 전달하는 것이 낫다. 이 변환을 한 번에 하지 않고 두 단계로 나눴다.normalizeSentryPayload() — Sentry의 중첩된 payload에서 핵심 식별자(이슈 ID, 이벤트 ID, 제목, URL, 환경, 프로젝트)만 평평하게 뽑아낸다. buildAiContext() — 정규화된 이슈와 원본 payload를 함께 받아, Claude에게 줄 AiDebugContext를 조립한다.굳이 나눈 이유는, 식별자 추출과 분석용 컨텍스트 조립의 성격이 다르기 때문이다. 식별자는 브랜치 이름(fix/sentry-{issueId})이나 임시 파일 경로처럼 시스템이 쓰는 값이라 안정성이 중요하고, 컨텍스트는 Claude가 읽을 내용이라 풍부함이 중요하다. 둘을 한 함수에 섞으면 책임이 뒤엉킨다. ID는 반드시 문자열로. 정규화 과정에서 가장 신경 쓴 부분이다. Sentry의 이슈/이벤트 ID는 큰 정수라서, 그대로 두면 후속 단계(특히 셸/CI 환경)에서 1.23e+15 같은 지수 표기로 변질될 수 있다. ID가 변질되면 브랜치 이름도, 임시 파일 경로도 어긋난다. 그래서 ID는 추출 시점에 명시적으로 문자열로 변환한다. 누락에 대비한 fallback chain. webhook payload는 환경과 SDK 버전에 따라 필드가 들쭉날쭉하다. 그래서 핵심 필드마다 우선순위 사슬을 뒀다.제목: issue.title → event.title → event.message → 기본값 프로젝트 슬러그: webhook 슬러그 → event 슬러그 → 프로젝트 이름 → 환경 변수 → 숫자 ID어느 한 경로가 비어도 다음 경로로 넘어가므로, 필드 하나가 없다고 파이프라인 전체가 멈추지 않는다. 이렇게 정리한 정보를 AiDebugContext 스키마로 묶는다. AiDebugContext { issue: { id, title, url, level, environment, project } event: { id, message, culprit, transaction, timestamp } stacktrace: { frames: [...], // 최근 20개 프레임 top_in_app_frame // 가장 관련성 높은 in-app 프레임 } breadcrumbs: { last_items: [...] // 최근 20개 브레드크럼 } runtime: { browser, os, device, url, user_agent } tags: { ... } ai_instructions: { // Claude에게 직접 전달하는 지시사항 goal, constraints, expected_output } }스택트레이스 처리. Sentry의 frames 배열은 오래된 것부터 최근 순으로 정렬된다. 최근 20개만 유지하고, in_app: true인 프레임 중 마지막 것을 top_in_app_frame으로 추출한다. Claude가 node_modules나 프레임워크 내부보다 실제 앱 코드에 집중하도록 유도하기 위해서다. 민감정보 마스킹. 브레드크럼의 data 필드에는 요청 헤더, 쿠키, 토큰이 포함될 수 있다. key 이름 기반으로 민감한 필드를 [REDACTED]로 치환한다. 설계 결정 5: Claude Code CLI 호출 방식 Claude Code CLI를 서버에서 프로그래매틱하게 실행할 때 고려한 것들. 프롬프트 전달. --print 모드에서 긴 프롬프트는 stdin으로 전달하는 것이 안정적이다. const proc = spawn( "claude", [ "--print", "--dangerously-skip-permissions", "--allowedTools", "Bash,Read,Edit,Write", ], { cwd: REPO_PATH, detached: true, stdio: ["pipe", "pipe", "pipe"] }, );proc.stdin.write(prompt); proc.stdin.end();working directory. Claude가 REPO_PATH(대상 레포)를 cwd로 실행되어야 파일 탐색과 수정이 올바르게 동작한다. 허용 도구. Bash(git 명령어, gh CLI), Read(파일 읽기), Edit/Write(코드 수정). 이 4가지면 분석 → 수정 → 커밋 → PR 생성 전체가 가능하다. 권한 프롬프트가 끼어들면 백그라운드 프로세스가 멈춰버리므로 --dangerously-skip-permissions로 비대화형 실행을 보장하되, 그만큼 허용 도구를 위 4가지로 좁혀 위험 범위를 제한했다. 프롬프트는 절차로 적는다. Claude에게 주는 프롬프트는 추상적인 목표("이 에러 고쳐줘") 대신, 따라야 할 절차를 순서대로 적었다.@/tmp/sentry-{issueId}.json의 스택트레이스와 브레드크럼을 분석한다 관련 소스 파일을 찾아 수정한다 fix/sentry-{issueId} 브랜치를 만든다 커밋하고 푸시한다 gh로 PR을 생성한다컨텍스트 파일을 프롬프트에 직접 붙이지 않고 @경로 참조로 넘기는 이유는, payload가 크면 프롬프트가 비대해지고, Claude가 파일을 직접 Read하게 두는 편이 토큰 측면에서도 깔끔하기 때문이다. 프로세스의 뒷정리. spawn한 프로세스의 close 이벤트에서 두 가지를 한다. 하나는 /tmp/sentry-{issueId}.json 임시 파일 삭제(실패하더라도 try-catch로 흘려보낸다), 다른 하나는 stdout/stderr와 종료 코드 로깅이다. 다만 Claude의 출력은 길어질 수 있어 로그는 500자로 잘라 남긴다. 백그라운드라 화면에 아무것도 안 뜨는 만큼, 나중에 "무슨 일이 있었는지" 추적할 최소한의 단서는 남겨두는 것이다. 설계 결정 6: 왜 PR까지만 만들고 멈추는가 파이프라인의 마지막 단계는 gh pr create다. 마음만 먹으면 gh pr merge까지 붙여서 "에러 발생 → 자동 수정 → 자동 배포"로 완전 무인화할 수도 있었다. 하지만 의도적으로 PR 생성에서 멈추도록 설계했다. 이유는 단순하다. AI의 수정은 틀릴 수 있다. 스택트레이스만 보고 증상을 가린 채 근본 원인을 놓칠 수도 있고, 엉뚱한 파일을 건드릴 수도 있다. 자동 merge까지 열어두면, 잘못된 수정이 아무 검토 없이 메인 브랜치로 들어가 또 다른 장애를 만든다. 그래서 이 시스템의 역할을 "고치는 주체"가 아니라 "리뷰할 거리를 만들어두는 주체"로 한정했다. Claude가 하는 일은 사람이 처음부터 해야 했을 일(에러를 분석하고, 원인을 추정하고, 수정안을 코드로 만들어 PR에 정리하는 것) 까지다. 그 PR을 받아들일지 말지는 사람이 결정한다. 반복적인 앞단을 자동화하되, 마지막 판단 게이트는 사람에게 남긴다는 것이 이 설계의 핵심 안전장치다. 전체 흐름 정리 [Sentry] 에러 발생 │ │ POST /webhooks/sentry?secret=... ▼ [nginx] TLS termination │ │ proxy_pass localhost:3000 ▼ [Node.js - Hono] ├─ secret 검증 ├─ payload 파싱 ├─ AiDebugContext 빌드 ├─ /tmp/sentry-{id}.json 저장 └─ claude CLI spawn (background) │ │ 즉시 200 응답 ▼ [Sentry] 완료 처리 (백그라운드) ▼ [Claude Code CLI] ├─ /tmp/sentry-{id}.json 분석 ├─ KOIN_WEB_RECODE 탐색 ├─ 코드 수정 ├─ git checkout -b fix/sentry-{id} ├─ git commit & push └─ gh pr create ▼ [GitHub] PR 생성 완료남은 과제: 실패와 중복을 어떻게 다룰 것인가 지금까지의 구조는 "에러 하나가 정상적으로 들어와서, Claude가 한 번에 잘 고치는" 행복한 경로를 가정한다. 하지만 실제 운영에서는 그렇지 않은 경우가 더 많다. 현재 설계가 아직 충분히 답하지 못하는 두 가지 문제가 있다. 실패가 보이지 않는다. fire-and-forget의 대가다. Claude가 중간에 죽거나, 수정이 엉뚱하거나, push 권한 문제로 PR 생성에 실패해도 그 사실이 어디에도 드러나지 않는다. 지금은 프로세스의 close 이벤트에서 종료 코드와 출력 일부를 로그로 남기는 정도가 전부라, 서버에 직접 들어가 로그를 봐야 한다. webhook을 즉시 끊어버린 대신, 결과를 되돌려 알릴 채널이 사라진 셈이다. 자연스러운 다음 수순은 처리 결과(성공/실패, 생성된 PR 링크, 실패 사유)를 Slack이나 Sentry 이슈 코멘트로 다시 쏘는 것이다. 비동기로 일을 떠넘긴 만큼, 결과를 회수할 경로를 따로 만들어야 한다. 같은 에러가 반복해서 들어온다. Sentry는 동일한 이슈에 대해 alert을 여러 번 보낼 수 있다. 그런데 브랜치 이름은 fix/sentry-{issueId}로 이슈 ID에 고정돼 있다. 같은 이슈가 두 번 들어오면 두 번째 실행은 이미 존재하는 브랜치와 충돌하거나, 같은 내용의 PR을 중복으로 만들려다 깨진다. 결국 멱등성(idempotency) 문제다. "이 이슈는 이미 처리했는가"를 판단할 상태가 어디에도 없다. 처리한 이슈 ID를 기록해두고 중복 요청을 앞단에서 스킵하거나, 브랜치·PR의 존재 여부를 먼저 확인하는 가드가 필요하다. 여기에 더해, 장애 상황에서 알림이 한꺼번에 쏟아지면 Claude 프로세스가 무제한으로 spawn되는 동시성 문제도 같은 뿌리에서 나온다. 세 문제 모두 "받은 요청에 상태를 부여하지 않았다"는 한 지점으로 모인다. 지금 구조는 요청을 받는 즉시 잊어버리기 때문에, 신뢰성을 한 단계 끌어올리려면 결국 요청에 식별자와 상태(접수됨 / 처리 중 / 완료 / 실패)를 부여하는 최소한의 상태 저장소가 필요해진다. 에러 처리 다시 보기: 실패를 상태와 알림으로 바꾸기 위에서 남겨둔 과제를 실제로 손보면서, 이 서버의 에러 처리를 처음부터 다시 들여다봤다. 관점은 하나로 모였다. 이 서버는 외부(Sentry) → 외부(Claude CLI, GitHub, Sentry API)를 잇는 중계자라서, 내가 통제할 수 없는 입력과 통제할 수 없는 실패가 사방에 깔려 있다. 그래서 에러 처리를 "예외 잡기"가 아니라 흐름의 각 단계마다 실패를 어디서 끊고, 어떤 상태로 남기고, 누구에게 알릴지의 문제로 보기로 했다. 1. 요청 처리 흐름을 단계별 "관문"으로 나누기 webhook 핸들러는 순서가 곧 방어선이다. 각 단계가 실패하면 그 단계에 맞는 HTTP 상태 코드로 즉시 끊는다. POST /webhooks/sentry ├─ 1. 시크릿 검증 불일치 → 401 ├─ 2. body 읽기(타임아웃) 초과 → 408 ├─ 3. JSON 파싱 실패 → 400 ├─ 4. issueId 추출 없음 → 400 ├─ 5. 멱등성 체크 중복 → 200 (skipped) └─ 6. 처리 수락 → 200 (accepted)핵심은 "잘못된 입력(4xx)"과 "내 잘못(5xx)"을 분리한 것이다. 시크릿 불일치, 깨진 JSON, issueId 누락은 전부 클라이언트 책임(4xx)이라 재시도해도 의미가 없다. Sentry가 불필요하게 재발송하지 않도록 명확히 거절한다. 2. "body가 안 끝나는" 문제 — 타임아웃으로 멈춰버리는 현상 차단 가장 골치 아팠던 건 서버리스(Vercel) 환경에서 요청 body 읽기가 끝나지 않고 멈춰버리는 현상이었다. 이건 일반 try/catch로는 못 잡는다. 멈춘 Promise는 예외를 던지지 않기 때문이다. 그래서 Promise.race로 타임아웃을 강제로 씌웠다. function withTimeout<T>( promise: Promise<T>, ms: number, label: string, ): Promise<T> { return Promise.race([ promise, new Promise<never>((_, reject) => setTimeout( () => reject(new Error(`${label} timed out after ${ms}ms`)), ms, ), ), ]); }raw = await withTimeout(c.req.text(), BODY_READ_TIMEOUT_MS, "body-read"); // 8초"응답이 없는 실패"는 "에러를 던지는 실패"보다 위험하다. 타임아웃은 그 무응답을 다시 명시적 에러(408)로 바꿔주는 장치다. 3. 멱등성 — 같은 에러로 PR을 두 번 만들지 않기 앞서 과제로 남겼던 멱등성 문제를 여기서 푼다. Sentry webhook은 재시도되거나 중복 발송될 수 있다. 그대로 두면 하나의 에러에 PR이 여러 개 생긴다. 그래서 issueId 기준으로 처리 상태를 파일에 기록하고, 이미 processing/completed면 건너뛴다. const existing = processedStore.get(issue.issueId); if (existing?.status === "processing" || existing?.status === "completed") { return c.json({ ok: true, status: "skipped", ... }); // 중복은 정상 응답으로 흡수 }상태는 processing → completed | failed 세 가지로 관리한다. 주목할 두 가지 디테일이 있다.원자적 쓰기. 임시 파일에 쓴 뒤 rename으로 교체해서, 쓰는 도중 죽어도 스토어가 깨지지 않는다. 쓰기 직렬화. 동시 요청이 같은 파일을 덮어쓰지 않도록 writeChain Promise로 순차 처리한다.const tmp = `${path}.tmp`; writeFileSync(tmp, JSON.stringify(store, null, 2)); renameSync(tmp, path); // 원자적 교체4. 비동기 백그라운드 작업 — 응답은 먼저, 실패는 따로 알림 Claude Code 실행은 수 분이 걸린다. webhook 응답을 그때까지 붙잡고 있으면 Sentry 쪽이 타임아웃된다. 그래서 응답을 먼저 202 accepted 성격으로 돌려주고, 실제 작업은 detached 프로세스로 분리했다(앞서 설명한 fire-and-forget). await processedStore.markProcessing(issue.issueId); runClaudeCode(issue, aiContext); // await 하지 않음 — fire and forget return c.json({ ok: true, accepted: true, issueId: issue.issueId, ... });여기서 문제는 "응답을 이미 보낸 뒤의 실패는 어떻게 알리나"이다. HTTP로는 못 알린다. 그래서 결과를 두 곳(상태 저장소 + Sentry 코멘트)에 남긴다. proc.on("close", (code) => { if (code === 0) { processedStore.markCompleted(issueId, prUrl); postIssueComment(issueId, `🤖 수정 PR을 생성했습니다: ${prUrl}`); } else { processedStore.markFailed(issueId, `exit code ${code}`); postIssueComment(issueId, `⚠️ 자동 수정에 실패했습니다 (exit ${code}).`); } });성공/실패가 Sentry 이슈 코멘트로 다시 돌아가서, 개발자가 원래 보던 화면에서 결과를 확인한다. 앞 섹션에서 "결과를 회수할 경로가 없다"고 적었던 빈자리가 이걸로 메워졌다. 백그라운드 작업의 에러 처리는 "로그를 남기는 것"이 아니라 "사람에게 닿게 하는 것"이 핵심이다. 5. 알림 자체가 실패해도 본체는 안 죽는다 마지막 방어선. Sentry 코멘트 API 호출이 실패하더라도 그건 부가 기능이라 전체를 무너뜨리면 안 된다. 그래서 알림은 전부 "삼키는(swallow)" 에러 처리로 감쌌다. if (!env.SENTRY_API_TOKEN) { logger.warn("토큰 없음, 코멘트 스킵"); return; // 토큰 없어도 throw 안 함 } try { const res = await fetch(url, { signal: AbortSignal.timeout(10_000) }); if (!res.ok) { logger.warn(...); return; } } catch (err) { logger.warn("Failed to post Sentry comment", ...); // 실패해도 warn만 }AbortSignal.timeout(10_000)으로 외부 API 호출에도 타임아웃을 걸어, 느린 외부 의존성이 백그라운드 프로세스를 잡아두지 못하게 했다. 정리 — 에러 처리 5가지 원칙 이번 작업에서 일관되게 적용한 원칙을 추리면 다섯 가지다.단계마다 끊어라 — 실패 지점에 맞는 상태 코드로 즉시 거절 (4xx vs 5xx 분리) 무응답도 에러다 — hang은 타임아웃으로 명시적 에러로 변환 (Promise.race, AbortSignal.timeout) 중복을 흡수하라 — 멱등성으로 재시도/중복 발송을 안전하게 무시 응답 이후의 실패는 다른 채널로 알려라 — HTTP 대신 Sentry 코멘트로 결과 회신 부가 기능 실패가 본체를 죽이면 안 된다 — 알림은 swallow + 로깅한 줄 요약: 중계 서버의 에러 처리는 예외를 잡는 게 아니라, 통제 불가능한 외부 실패를 통제 가능한 상태와 알림으로 바꾸는 일이다.이렇게 해서 앞에서 남겨둔 세 과제(실패 가시성, 멱등성, 동시성)가운데 앞의 둘은 상태 저장소와 코멘트 회신으로 메워졌다. 동시성 제어(같은 이슈에 대한 프로세스 spawn 상한)는 멱등성 체크가 1차 방어선 역할을 하지만, 서로 다른 이슈가 한꺼번에 쏟아지는 경우의 큐잉은 아직 더 다듬을 여지가 남아 있다. 마치며 이 파이프라인의 핵심은 화려한 기술이 아니라, 불필요한 중간 단계를 걷어내는 것이었다. 처음엔 Vercel과 GitHub Actions를 거치는 5단계 구조였지만, "누가 webhook을 받고 누가 Claude를 실행하는가"를 다시 묻자 Oracle 하나로 충분하다는 답이 나왔다. 나머지 설계 결정들(직접 HTTPS, fire-and-forget, 구조화된 컨텍스트, CLI 호출 방식)은 모두 그 단순한 골격 위에서 각자의 트레이드오프를 따져 내린 선택이다.코드는 dooohun/koin-sentry-webhook에서 확인할 수 있다.
- 29 May, 2026
문자열 +=는 정말 O(N²)일까? V8의 ConsString 들여다보기
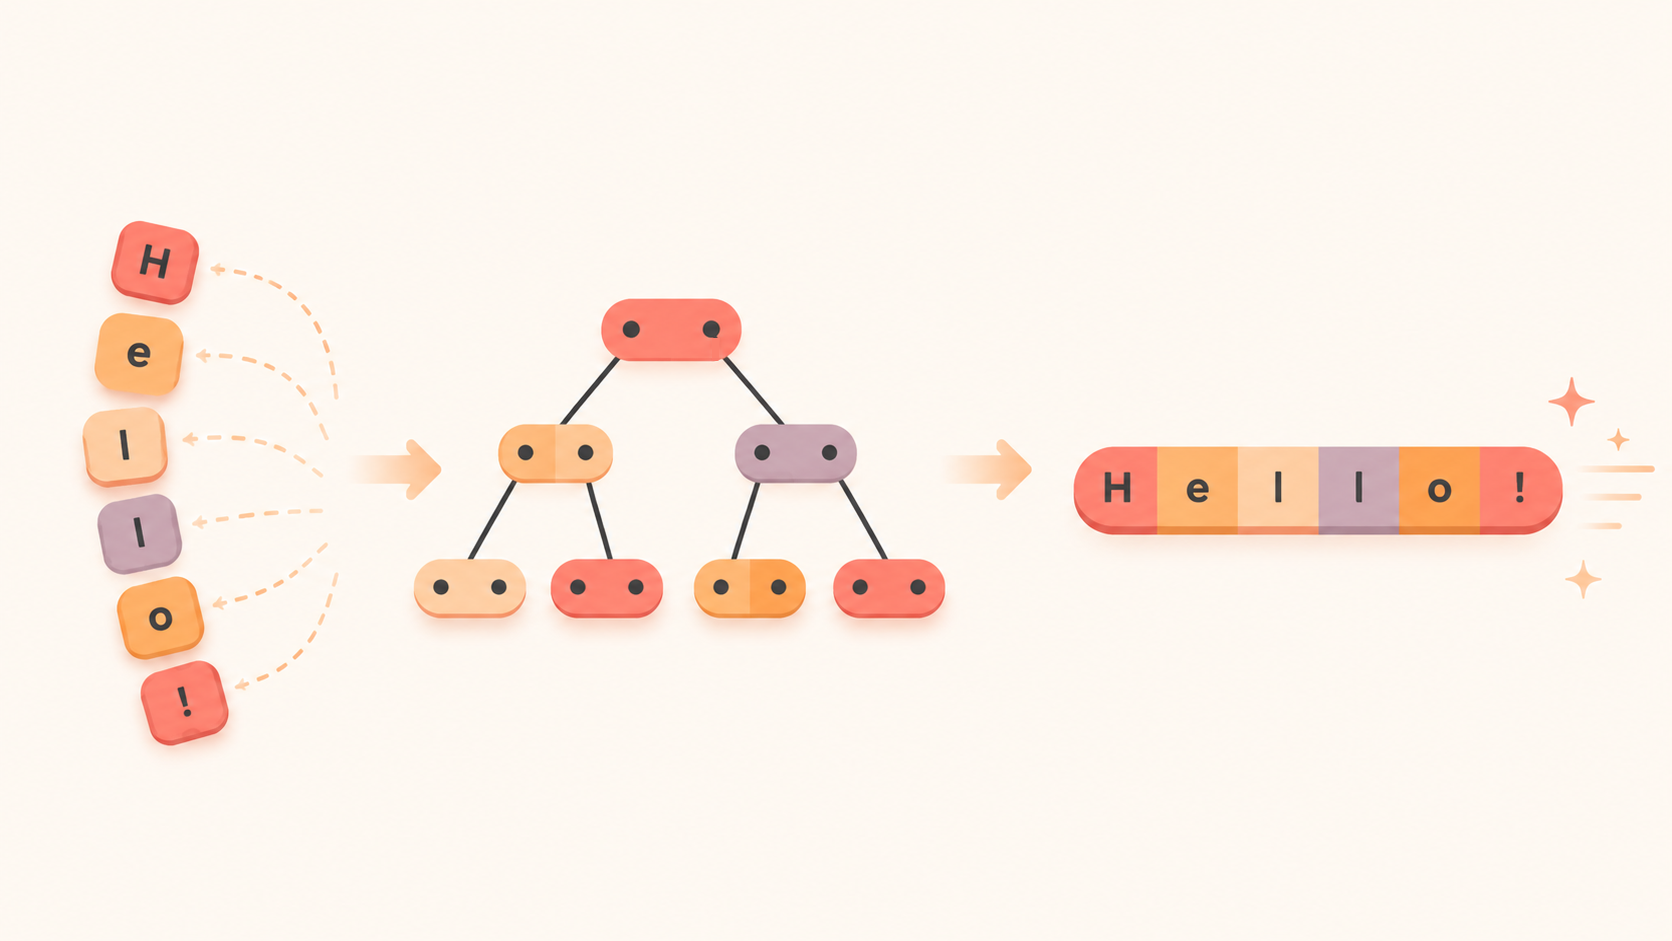
문자열이 여러 개 있을 때 모든 문자열들을 합쳐야 한다. 그럴 때 우리는 이렇게 코드를 짤 수 있다. function joinWords(words) { let sentence = ""; for (const word of words) { sentence += word; } return sentence; }JavaScript에 익숙하다면 join 메서드를 사용할 수 있다. function joinWords(words) { return words.join(""); }첫 번째 방식을 보면 "문자열은 불변(immutable)이라서, += 는 매번 새 문자열을 통째로 복사하기 때문에 N개를 이어 붙이면 O(N²)이 된다. 그렇기 때문에 Array.prototype.join()을 써야 한다." 라는 생각이 우선 든다. 문자열은 실제로 불변이고, sentence += word 는 기존 문자열을 고치는 게 아니라 기존 내용과 새 단어를 합친 새 문자열을 만들어 대입한다. 이론적으로는 단계마다 누적 길이만큼 복사가 일어나니 O(N²)이 맞다. 그런데 실제로 시간을 측정해보면 이야기가 달라진다. 그 이유를 만드는 V8 내부 장치인 ConsString을 들여다보고, 직접 만든 모델 코드와 실제 벤치마크로 확인해보려고 한다. ConsString - 일단 합치지 않고 미룬다. V8(Chrome과 Node.js의 JavaScript 엔진)은 두 문자열을 연결할 때 곧바로 문자를 복사하지 않는다. 대신 "이 둘이 이어져 있다"는 사실만 기록한 노드를 만든다. 이 노드가 ConsString(concatenated string) 이다. 여러 번 이어붙이면 이 노드들이 트리 구조로 쌓인다. 실제 문자 복사는 그 문자열의 내용이 정말로 필요해지는 순간까지 미뤄진다. 이것을 지연 평가(lazy evaluation)라고 부른다. 원리를 코드로 확인해보기 위해, ConsString의 핵심 동작만 흉내 낸 모델을 만들어보았다. (실제 V8 코드는 아니다. 어디까지나 멘탈 모델을 코드로 표현한 것이다.) // 평탄화 횟수 let flattenCount = 0;class ConsString { constructor(left, right) { // 즉시 합치지 않고 두 조각의 참조만 들고 있는다. => O(1) this.left = left; this.right = right; this.length = left.length + right.length; this._flat = null; } concat(other) { return new ConsString(this, other); } flatten() { if (this._flat !== null) return this._flat; flattenCount++; const l = this.left instanceof ConsString ? this.left.flatten() : this.left; const r = this.right instanceof ConsString ? this.right.flatten() : this.right; return (this._flat = l + r); } toString() { return this.flatten(); } }let s = ""; for (const w of ["hello", "my", "name", "dohun"]) { s = s === "" ? w : new ConsString(s, w); }console.log(flattenCount); // 0 console.log(s.toString()); // "hellomynamedohun" console.log(flattenCount); // 2 s.toString(); console.log(flattenCount); // 2연결을 끝낸 시점의 평탄화 횟수는 0이다. 노드만 쌓았을 뿐 실제 합치기는 한 번도 일어나지 않았다. 이게 연결 자체는 O(1)의 시간복잡도를 가지게 된다. toString() 으로 내용을 요구하는 순간 비로소 트리가 펼쳐지고, 한 번 펼친 결과는 캐싱되어 다음 요구부터는 다시 펼쳐지지 않는다. 결과적으로 l + r 도 복사가 아닌가? flatten() 안의 this._flat = l + r은 분명히 문자열 연결이고, 내부적으로 문자를 복사해 새 문자열을 만든다. 결과적으로 ConsString이 복사를 없앤 게 아니지 않은가? 맞다. ConsString이 없애는 건 복사 자체가 아니라 중간 단계마다 반복되는 복사이다. 예시로 [a, b, c, d]가 합쳐지는 과정을 보자. s = a (복사 없음) s = s + b → "a" + "b", 길이 2 복사 s = s + c → "ab" + "c", 길이 3 복사 s = s + d → "abc" + "d", 길이 4 복사매 단계에서 그때까지 누적된 전체를 다시 복사한다. 복사량이 쌓여 O(N²)이 된다. 같은 앞부분을 거듭 복사하는 것이 중요한 내용이다. 하지만 ConsString은 연결 단계에서 단 한번 마지막에 복사를 해서 합쳐질 뿐 매번 누적해서 복사하지 않는다. 그렇기에 O(N)으로 줄어든다. 언제 평탄화가 되는가? ConsString은 두 조각이 이어져 있다라는 지연된 표현이다. 임의 위치의 문자에 실제로 접근해야 하는 연산이 들어오면 그 시점에 트리를 하나의 연속된 버퍼로 펼친다. 대표적인 트리거는 다음과 같다.인덱싱, 문자 접근: str[i], charAt, CharCodeAt 다수의 내장 메서드: 정규식 매칭, indexOf, slice 등 연속 버퍼가 필요한 연산 엔진 외부로 데이터를 넘길 때: console.log 출력, JSON 직렬화 등한 번 펼쳐지면 결과가 보관되어 이후 접근은 빠르다. 모델과 실제 V8의 차이 위 모델은 원리를 보여줄 뿐, 실제 V8과는 다음 점에서 다르다.V8은 결과 문자열 길이가 약 13자 미만이면 ConsString을 만들지 않고 즉시 복사한다. 노드 객체 자체의 메모리 오버헤드가 짧은 문자열에는 손해이기 때문이다. 실제 평탄화는 위 모델처럼 재귀로 + 하는 대신, 총 길이만큼 버퍼를 미리 할당해 한 번에 채운다. 캐싱도 별도 프로퍼티가 아니라 노드 자체를 평탄화된 표현으로 교체하는 방식이다.성능 측정 세 가지 방식을 여러 N에서 비교했다.+= 누적 배열을 join("") 빈 배열에 push 한 뒤 join("")Node v22.22.2, 각 케이스를 20회 워밍업 후 11회 측정한 중앙값(ms)이다. 단어는 2~4자 길이를 사용했다. V8은 처음엔 코드를 느린 인터프리터로 실행하다가, 충분히 반복되면 최적화 컴파일러(JIT)가 빠른 기계어로 다시 컴파일한다. 그래서 처음 몇 번은 느리다. 측정 전에 함수를 미리 여러 번 돌려 이 최적화를 끝내 두는 것이 워밍업이다. 안 하면 "데워지기 전"의 느린 상태를 측정하게 된다. 짧은 단어 (2~4자)N (단어 수) += 배열 join() push + join()1,000 0.01 0.01 0.0210,000 0.06 0.16 0.2150,000 0.31 1.16 1.80100,000 0.62 2.6 4.1500,000 3.85 16.5 25.91,000,000 33.5 34.8 565,000,000 329 231 597긴 단어 (~31자)N (단어 수) += 배열 join() push + join()10,000 0.06 0.4 0.48100,000 0.62 4.0 5.4500,000 3.9 27.4 37.41,000,000 33.4 52.7 76.85,000,000 289 270 579+= 는 O(N²)이 아니다. ConsString이 올바르게 작동하고 있다는 직접적인 증거이다. 소~중 규모에서는 오히려 += 가 빠르다. join() 은 별도 배열을 순회하고 평탄화하는 비용을 치르기 때문이다. 역전은 수백만 단어 규모에서 발생한다. 즉 join()이 빠르다는 건 큰 입력에서 성립한다. 단어가 길수록 역전이 더 늦는다. 긴 단어 500만에서는 둘이 거의 비슷하다. 단어가 길면 다뤄야 할 노드 수는 같은데 복사할 총 바이트가 늘어, join()의 버퍼 선할당 이점이 상대적으로 덜 두드러진다.결론 "문자열은 불변이니 +=는 O(N²), 무조건 join()"이라는 통념은 알고리즘 수업에서는 맞지만, 실제 V8 런타임에서는 ConsString 덕분에 둘 다 O(N)에 가깝게 동작한다. 그리고 측정해 보면 일상적 규모에서는 오히려 +=가 빠른 경우가 많다. 실무적으로 정리하면.대부분의 경우(수천~수십만 단어) +=로 충분하고, 종종 더 빠르다. 그러니 읽기 쉽고 의도가 분명한 쪽을 고르면 된다. 단어들을 이미 배열로 들고 있다면 words.join("")이 가장 간결하다. 두 방식의 성능이 역전되는 건 수백만 단어 이상의 큰 입력에서다. 그런 규모이거나 메모리 사용량을 예측 가능하게 두고 싶다면 join()이 더 안정적이다. 무엇보다 ConsString의 13자 임계값 같은 내부 동작에 코드를 의존시키지 말 것. 그건 엔진이 알아서 잘하라고 있는 최적화이지, 우리가 기대고 설계할 대상이 아니다.참고V8's ConsString Optimization in JavaScript v8/v8 — src/objects/string.h How we made JSON.stringify more than twice as fast — V8 Blog V8. Working with Strings. Expanding Vocabulary — Frontend Almanac
- 29 May, 2026
Web Worker와 OffscreenCanvas로 이미지 업로드 최적화하기
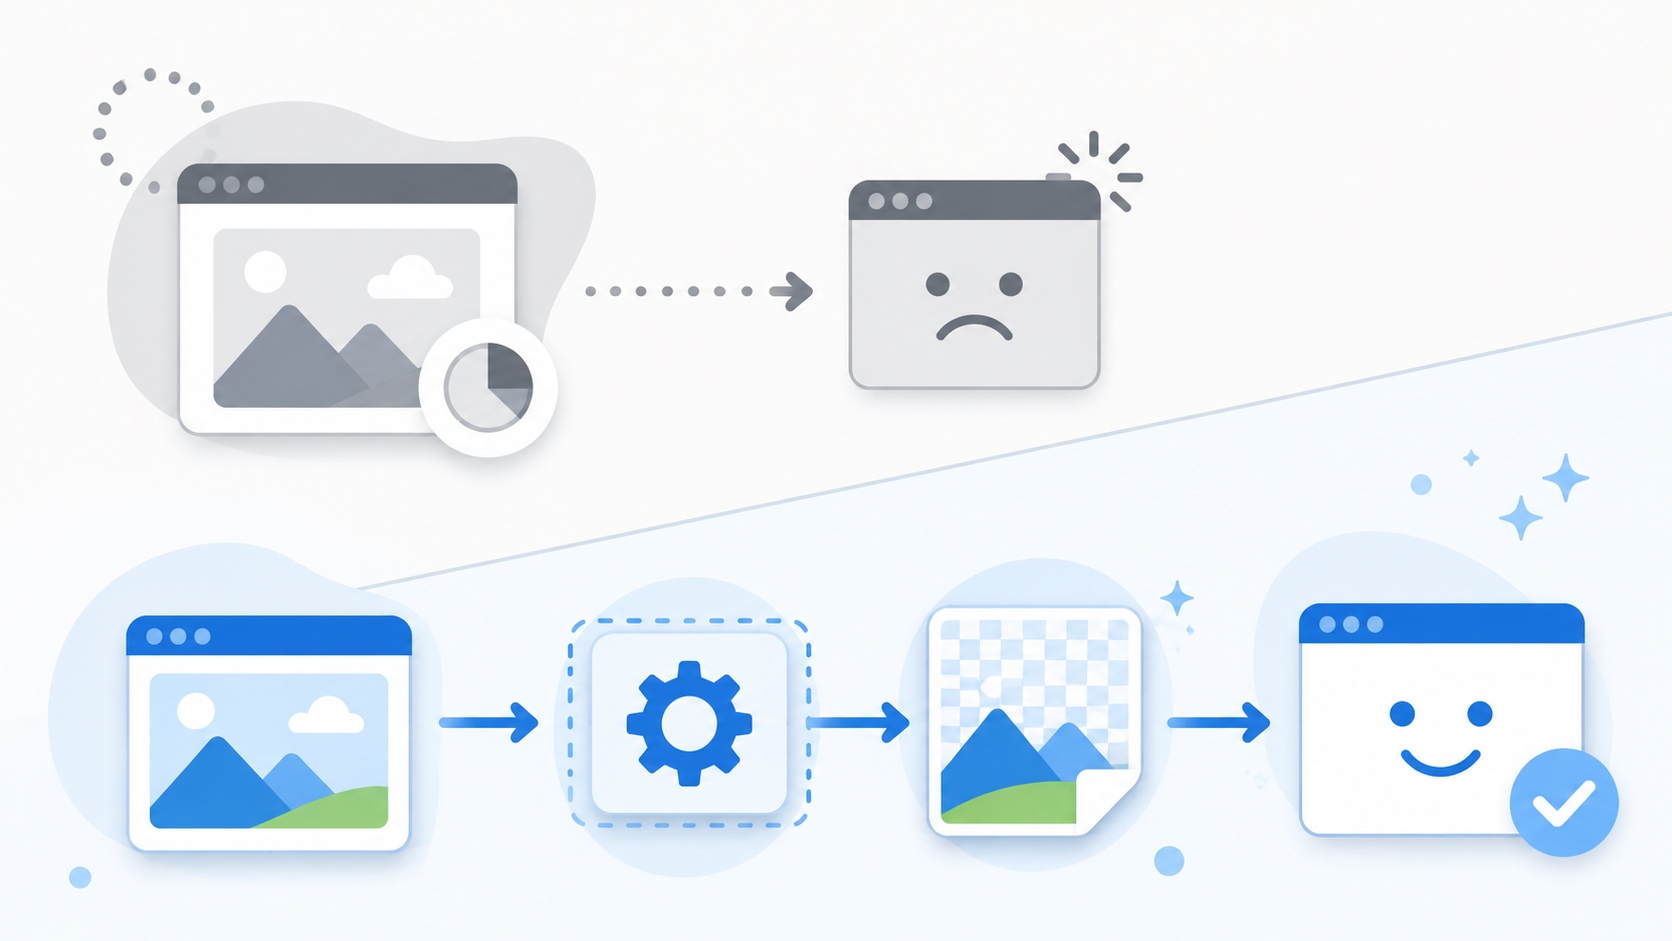
이번 글에서는 실제 서비스 개발 중 마주한 이미지 업로드 성능 문제를 Web Worker와 OffscreenCanvas 조합으로 해결한 과정을 정리했다. 처음에는 단순히 업로드가 느리다는 문제로 보였다. 하지만 원인을 따라가 보니 파일 크기, 이미지 처리 비용, 메인 스레드 블로킹이 함께 얽혀 있었다. 이 글에서는 그 문제를 어떻게 정의했고, 어떤 선택지를 검토했으며, 왜 이 방식이 적절했다고 판단했는지를 순서대로 정리해봤다. 특히 다음 질문에 답하는 흐름으로 글을 구성했다.왜 기존 방식이 느렸는가? 왜 Canvas API만으로는 충분하지 않았는가? 왜 Web Worker와 OffscreenCanvas를 함께 선택했는가? 이 선택이 사용자 경험에 어떤 차이를 만들었는가?문제 상황 서비스에서 이미지 업로드 기능을 구현할 때 처음에는 원본 파일을 그대로 서버로 전송하고 있었다. 스마트폰 카메라로 촬영한 이미지는 보통 3~8MB 정도였고, 이를 별도 처리 없이 업로드하니 평균 10초, 느릴 때는 30초까지 걸렸다. 겉으로는 “업로드가 느리다”는 한 문장이었지만, 실제 문제는 세 가지가 겹쳐 있었다.원본 이미지 자체가 너무 컸다. 리사이징이나 압축 없이 업로드하다 보니 전송해야 할 데이터 양이 과도했다. 모바일 환경에서 체감이 더 심했다. 모바일 네트워크 환경은 상대적으로 불안정했고, 카메라 원본 이미지는 데스크톱에서 다루는 이미지보다 훨씬 큰 경우가 많았다. 다중 이미지 업로드에서 대기 시간이 급격히 늘어났다. 이미지 한 장이 느린 것도 문제였지만, 여러 장을 올리면 그 지연이 그대로 누적됐다.즉, 이 문제는 단순한 속도 문제가 아니라 사용자가 기능을 쓰는 동안 기다려야 하는 시간 전체를 어떻게 줄일 것인가의 문제였다. 가장 먼저 떠오른 방법: Canvas API로 리사이징하기 클라이언트 사이드에서 이미지를 줄이는 방법으로 가장 먼저 떠오른 건 Canvas API였다. 브라우저에서 이미지를 drawImage()로 캔버스에 그린 다음, toBlob()으로 다시 압축하면 서버에 전송하는 파일 크기를 줄일 수 있었다. 이 접근 자체는 틀리지 않았다. 실제로 전송 용량은 줄어들고, 업로드 시간도 단축됐다. 문제는 어디에서 실행되느냐였다. Canvas API는 기본적으로 메인 스레드에서 동작했다. 이미지 디코딩, 리사이징, 다시 인코딩하는 작업은 생각보다 CPU 비용이 컸고, 이 작업이 메인 스레드를 점유하는 동안 브라우저는 사용자 입력과 화면 갱신에 제대로 반응하지 못했다. 단일 이미지라면 잠깐 버틸 수 있었을지도 모른다. 하지만 여러 장의 이미지를 순차적으로 처리하면 다음과 같은 일이 벌어졌다.이미지 하나를 처리할 때마다 UI가 잠깐씩 멈췄다. 업로드 버튼, 스크롤, 입력 같은 상호작용이 버벅였다. 사용자는 “느리다”를 넘어 “멈췄다”고 느끼게 됐다.즉, Canvas API만으로는 파일 크기 문제는 줄일 수 있어도, UI 블로킹 문제까지 함께 해결하기는 어려웠다.(UI 블로킹 발생) Web Worker + OffscreenCanvas 최종적으로 선택한 방법은 Web Worker + OffscreenCanvas 조합이었다. 이 조합이 적절하다고 판단한 이유는 명확했다. 1. 무거운 작업을 메인 스레드에서 분리할 수 있었다 Web Worker는 메인 스레드와 별도로 동작하는 백그라운드 스레드다. 이미지 디코딩, 리사이징, 압축처럼 CPU를 많이 쓰는 작업을 Worker 쪽으로 넘기면, 메인 스레드는 UI 렌더링과 사용자 입력 처리에 집중할 수 있었다. 즉, 업로드 성능을 개선하면서도 화면이 멈추지 않는 경험을 만들 수 있었다. 2. 브라우저 네이티브 API만으로 해결할 수 있었다 OffscreenCanvas는 DOM과 분리된 캔버스다. 이 덕분에 Worker 내부에서도 캔버스를 생성하고 이미지를 그린 뒤 convertToBlob()으로 결과를 만들 수 있었다. 중요했던 점은 이것이 별도 라이브러리 없이 가능한 방식이었다는 점이었다. sharp나 browser-image-compression 같은 라이브러리를 도입하지 않고도, 브라우저가 제공하는 기능만으로 충분히 목적을 달성할 수 있었다. 3. 디코딩까지 Worker 안에서 처리할 수 있었다 여기에 createImageBitmap()까지 함께 사용하면 이미지 디코딩도 Worker 스코프 내부에서 수행할 수 있었다. 즉, 전체 플로우를 다음처럼 구성할 수 있었다.메인 스레드는 File 객체를 Worker에 전달했다. Worker는 createImageBitmap()으로 이미지 디코딩을 수행했다. OffscreenCanvas에 리사이징된 이미지를 그렸다. convertToBlob()으로 압축 결과를 생성했다. 최종 Blob만 다시 메인 스레드로 전달했다.이 구조에서는 메인 스레드가 무거운 연산에 직접 개입하지 않았다. 결과적으로 “파일 크기를 줄인다”와 “UI를 멈추지 않게 한다”를 동시에 달성할 수 있었다.(Canvas API와 WebWorker + OffscreenCanvas 비교) Web Worker가 왜 중요한가 JavaScript는 기본적으로 단일 스레드 환경에서 동작한다. 브라우저는 스크립트 실행, 레이아웃 계산, DOM 업데이트, 사용자 입력 처리 등을 모두 메인 스레드에서 수행한다. 그래서 CPU 비용이 큰 작업이 메인 스레드를 오래 점유하면 다음 문제가 발생했다.클릭이나 입력에 대한 반응이 늦어졌다. 스크롤이 끊겼다. 애니메이션이 버벅였다. 사용자는 앱이 느리거나 멈췄다고 인식하게 됐다.이런 맥락에서 Web Worker는 단순한 “병렬 처리 도구” 이상이었다. 이는 사용자 경험을 보호하기 위한 격리 장치에 가까웠다. 특히 이 문제는 Core Web Vitals의 INP(Interaction to Next Paint) 와도 연결된다. 사용자가 어떤 상호작용을 했을 때 다음 화면 반응이 나타나기까지의 시간을 측정하는 지표인데, 메인 스레드에 긴 작업(Long Task)이 많을수록 INP는 나빠진다.(수정 전 4MB 이미지 7개 다중 요청 시 Long task) 이미지 처리처럼 계산량이 큰 작업을 Worker로 넘긴다는 것은, 단순히 구현을 분리하는 것이 아니라 인터랙션 품질을 지키는 방향으로 아키텍처를 바꾸는 것이라고 볼 수 있었다. OffscreenCanvas가 필요한 이유 기존 <canvas> 요소는 DOM에 묶여 있기 때문에 메인 스레드에서 주로 다뤘다. 반면 OffscreenCanvas는 DOM과 분리된 캔버스였고, Worker 내부에서도 사용할 수 있었다. 이 점이 중요한 이유는 이미지 최적화 과정 자체가 캔버스 기반 작업을 필요로 했기 때문이다. 이미지 최적화 과정은 보통 다음 단계를 거쳤다.이미지 디코딩 원하는 크기로 리사이징 다시 압축된 포맷으로 인코딩여기서 2번과 3번을 처리하려면 캔버스 기반 작업이 필요했다. 그런데 일반 Canvas API만 사용하면 결국 이 처리가 메인 스레드 쪽에 남게 됐다. OffscreenCanvas를 사용하면 이 작업까지 Worker 안으로 옮길 수 있었다. 즉, “연산은 Worker에서 하지만 캔버스는 메인 스레드에서 다룬다” 같은 반쯤 분리된 구조가 아니라, 디코딩부터 압축 결과 생성까지 한 스레드 안에서 일관되게 처리할 수 있었다. 이 점이 이번 구조의 핵심이었다. createImageBitmap createImageBitmap()은 Blob, File 같은 소스로부터 디코딩된 비트맵을 비동기적으로 생성하는 API다. 이번 구현에서 특히 유용했던 이유는 두 가지였다.Worker 내부에서 직접 호출할 수 있어서 메인 스레드 부담이 없었다. 디코딩된 결과를 바로 캔버스에 그리기 좋았다.즉, <img> 태그를 만들고 로드 이벤트를 기다리는 식의 흐름보다 훨씬 단순했고, Worker 환경에 자연스럽게 녹아들었다. 이미지 처리 최적화에서는 보통 “리사이징”에만 집중하기 쉬운데, 실제로는 디코딩 비용도 무시할 수 없었다. 그래서 createImageBitmap()을 함께 사용한 것이 꽤 큰 의미가 있었다. 구현 방식 실제 구현은 크게 두 부분으로 나뉘었다.Worker에서 실제 이미지 처리를 수행했다. 메인 스레드에서 Worker와 통신하고 결과를 업로드 플로우에 연결했다.1. Worker에서 이미지 처리하기 Worker는 file, maxWidth, quality, format 값을 전달받아 다음 순서로 작업했다.createImageBitmap(file)로 이미지 디코딩을 수행했다. maxWidth를 초과하면 비율을 유지한 채 리사이징했다. OffscreenCanvas에 이미지를 그렸다. convertToBlob()으로 압축된 결과를 생성했다. 결과 Blob을 메인 스레드로 전달했다./// <reference lib="webworker" />self.onmessage = async (event: MessageEvent) => { const { file, maxWidth = 1920, quality = 0.8, format = "image/jpeg", } = event.data; try { const bitmap = await createImageBitmap(file); let { width, height } = bitmap; if (width > maxWidth) { height = Math.round((height * maxWidth) / width); width = maxWidth; } const canvas = new OffscreenCanvas(width, height); const ctx = canvas.getContext("2d"); if (!ctx) { throw new Error("Canvas 2D context not available"); } ctx.drawImage(bitmap, 0, 0, width, height); const blob = await canvas.convertToBlob({ type: format, quality, }); bitmap.close(); self.postMessage({ success: true, blob, width, height }); } catch (error) { self.postMessage({ success: false, error: (error as Error).message, }); } };여기서 핵심은 무거운 처리가 모두 Worker 안에서 끝난다는 점이었다. 메인 스레드는 최적화된 결과만 전달받았다. 또 하나 중요했던 부분은 bitmap.close()였다. ImageBitmap은 사용 후 명시적으로 정리해주는 편이 안전했다. 이미지 여러 장을 다룰 때는 이런 작은 정리 하나가 메모리 사용량에 꽤 큰 차이를 만들 수 있었다. 2. 메인 스레드에서 Worker와 통신하기 메인 스레드에서는 processImage() 함수가 Worker 생성, 메시지 전달, 결과 수신을 담당했다. const processImage = useCallback( async (file: File): Promise<File> => { if (!window.Worker) return file; return new Promise((resolve) => { const worker = new Worker( new URL("../workers/image-processor.worker.ts", import.meta.url), { type: "module" }, ); worker.onmessage = (event) => { const { success, blob } = event.data; worker.terminate(); if (success && blob) { resolve(new File([blob], file.name, { type: blob.type })); } else { resolve(file); } }; worker.onerror = () => { worker.terminate(); resolve(file); }; worker.postMessage({ file, maxWidth, quality }); }); }, [maxWidth, quality], );설계적으로는 몇 가지 포인트가 있었다. Worker를 이미지마다 생성하고 종료 처음에는 Worker Pool 같은 구조도 생각할 수 있었다. 하지만 이 경우에는 이미지 한 장을 처리한 뒤 바로 종료하는 단순한 구조가 더 적절했다.구현이 단순했다. 생명주기를 추적하기 쉬웠다. 메모리 누수 가능성을 줄이기 좋았다.처리량이 아주 큰 상황이 아니라면, 이런 단순한 구조가 유지보수 측면에서 오히려 이점이 컸다. 실패해도 업로드는 진행 이미지 최적화는 성능 개선을 위한 보조 단계이지, 업로드 성공 자체를 막아서는 안 됐다. 그래서 Worker 처리에 실패하더라도 reject로 흐름을 끊지 않고, 원본 파일을 그대로 반환하는 graceful fallback 구조를 선택했다. 이 판단 덕분에 브라우저 환경이나 예외 상황에 따라 최적화가 실패하더라도, 사용자는 적어도 업로드 기능 자체는 계속 사용할 수 있었다. 전체 업로드 플로우 최종 업로드 흐름은 다음처럼 정리됐다.사용자가 파일을 선택 파일 수, 타입, 용량 검증 processImage(file)를 호출해 Worker에서 최적화 최적화된 File을 업로드 상태를 업데이트해 UI에 반영이 구조 덕분에 이미지 최적화 로직은 공통으로 유지하면서도, 서비스 요구사항에 맞게 업로드 타이밍을 유연하게 제어할 수 있었다. 결과: 업로드 시간이 단축되고, 체감 역시 좋아졌다. 적용 전후를 직접 측정한 결과는 다음과 같았다.평균 업로드 시간: 10초 → 1.4초 최대 업로드 시간: 30초 → 2.8초수치로 보면 평균 약 86%, 최대 약 91% 개선이었다. 하지만 실제로 더 크게 느껴졌던 변화는 따로 있었다. 바로 업로드 중에도 UI가 멈추지 않는다는 점이었다. 사용자 입장에서 성능은 단순히 “작업이 얼마나 빨리 끝났는가”만으로 판단되지 않는다. 버튼이 눌리는지, 화면이 움직이는지, 뭔가 진행되고 있다는 느낌이 드는지도 매우 중요했다. 이번 개선은 전송 시간을 줄인 것뿐 아니라, 업로드 과정 전체를 덜 답답하게 만들었다. 특히 모바일에서 여러 장의 사진을 한 번에 선택했을 때 체감 차이가 크게 났다. 이번 작업에서 배운 점 이번 작업을 하면서 다시 확인한 건, 성능 문제를 해결할 때 가장 중요한 것은 무조건 빠른 도구를 찾는 것이 아니라는 점이었다. 먼저 해야 할 일은 보통 다음과 같았다.어디에서 시간이 오래 걸리는지 확인하기 그 병목이 네트워크인지, CPU인지, 렌더링인지 구분하기 단순한 속도 개선이 아니라 사용자 경험까지 함께 볼 수 있는지 판단하기이번 사례에서는 병목이 단순히 “업로드 요청”에만 있는 것이 아니었다. 큰 이미지 파일 자체, 클라이언트 리사이징 비용, 메인 스레드 블로킹이 모두 얽혀 있었다. 그래서 해결책도 단순 압축이 아니라, 이미지 처리 파이프라인을 메인 스레드 밖으로 분리하는 방향이어야 했다. 마치며 Web Worker와 OffscreenCanvas는 이미지 업로드 최적화에만 쓰이는 기술은 아니다. 3D 렌더링, 실시간 데이터 처리, 머신러닝 추론처럼 메인 스레드를 오래 점유하기 쉬운 작업 전반에 적용할 수 있다. 하지만 이번 경험을 통해 특히 인상 깊었던 건, 이 기술들이 거창한 대규모 시스템에서만 의미 있는 것이 아니라는 점이었다. 사용자가 이미지를 올리는 아주 일상적인 기능에서도, 스레드 분리와 브라우저 네이티브 API 조합만으로 체감 성능을 크게 개선할 수 있었다. 이번 작업은 단순히 “업로드를 빠르게 만들었다”는 것보다, 사용자가 기다리는 시간을 어떻게 줄이고, 그 기다림의 질을 어떻게 바꿀 것인가를 고민한 과정에 더 가까웠다. 비슷한 병목을 겪고 있다면, 이미지 파일 크기만 볼 것이 아니라 그 처리가 어디서 실행되고 있는지도 함께 살펴보면 좋겠다. 생각보다 큰 차이는 그 지점에서 만들어질 수 있었다. 참고 자료MDN — Using Web Workers web.dev — Web worker overview MDN — OffscreenCanvas web.dev — OffscreenCanvas: speed up your canvas operations with a web worker web.dev — Interaction to Next Paint (INP) Evil Martians — Faster WebGL/Three.js with OffscreenCanvas Chrome for Developers — Transferable objects are lightning fast
- 28 May, 2026
dnd-kit에 SnapToPointer modifier를 기여하기까지
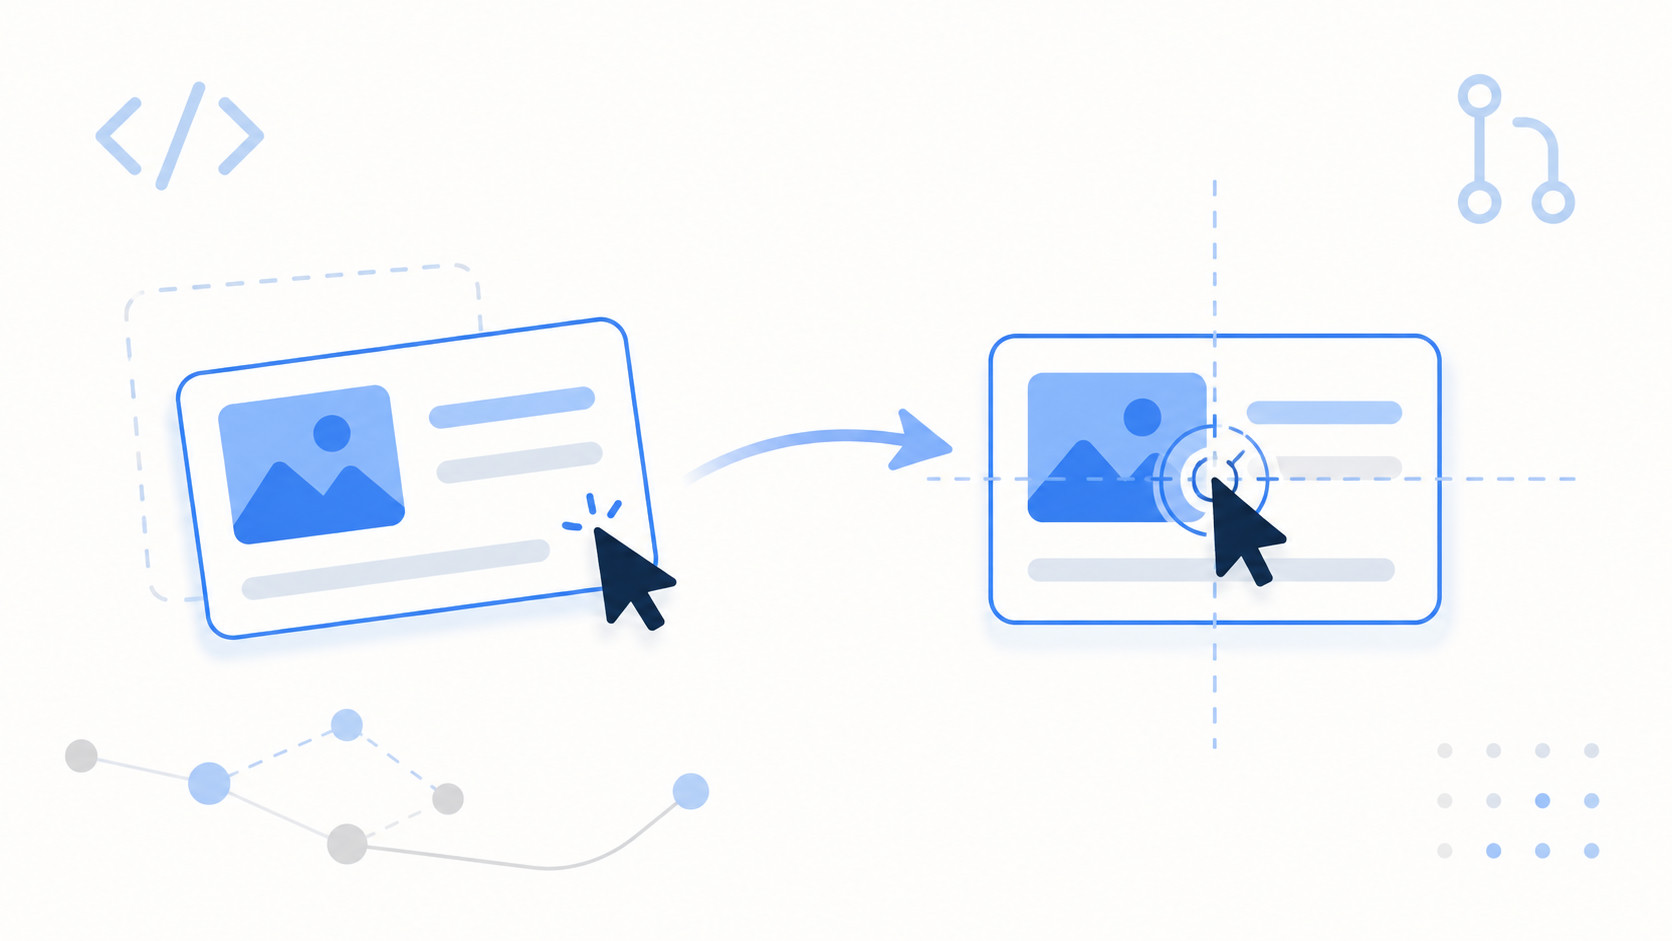
오픈소스 기여. 개발자라면 한 번쯤 해보고 싶은 일이지만, 막상 시작하려면 어디서부터 해야 할지 막막하다. 나 역시 그랬다. 이 글은 내가 어떻게 dnd-kit에 SnapToPointer modifier를 기여하게 됐는지, 그 과정에서 무엇을 배웠는지를 기록해보려고 한다. Drag and Drop 기능 구현 BCSD Lab이라는 대학 IT 동아리에서 내부 관리 서비스를 개발하던 중, 동아리 회의 가능 시간을 선택하는 기능을 맡게 됐다. Google Calendar에서 드래그로 일정을 만드는 것처럼, 마우스를 누른 채 셀 위를 지나가면 해당 시간대가 채워지는 기능이다. When2Meet의 메인 기능과 동일하다. const [dragStart, setDragStart] = useState<TimeSlotSelection | null>(null); const [dragEnd, setDragEnd] = useState<TimeSlotSelection | null>(null); const [dragging, setDragging] = useState(false);const handleMouseDown = ({ timeFrom, timeTo, day }: TimeSlotSelection) => { setDragging(true); setDragStart({ timeFrom, timeTo, day }); };const handleMouseUp = () => { const [startHourFrom, startMinuteFrom] = dragStart.timeFrom.split(':').map(Number); const [endHourTo, endMinuteTo] = dragEnd.timeTo.split(':').map(Number); // 위에서 아래로 드래그 vs 아래에서 위로 드래그를 직접 판별 if (startHourFrom < endHourTo || ((startHourFrom === endHourTo) && (startMinuteFrom <= endMinuteTo))) { setSelectionRange((prev) => [...prev, { start: { time: dragStart.timeFrom, day: dragStart.day }, end: { time: dragEnd.timeTo, day: dragEnd.day } }]); } else if (...) { ... } };이걸 제대로 하려면 '어떻게 설계해야 하는 걸까'라는 의문이 생긴 건 자연스러운 수순이었다. 생각보다 훨씬 복잡했다. 드래그 방향(위→아래 vs 아래→위)을 직접 시간 비교로 판별하고, 각 셀에 이벤트 핸들러를 개별로 붙이는 방식이다. 기능은 동작했지만 엣지케이스가 꽤 남아 있었고, 버그도 남아 있었다. 그 과정에서 자연스럽게 드래그 인터랙션을 제대로 처리하는 라이브러리들이 궁금해졌고, 그렇게 dnd-kit을 처음 알게 됐다. dnd-kit 소스를 파보다 dnd-kit은 단순한 drag-and-drop 유틸리티가 아니다. 코드를 열어보면 패키지부터 역할이 명확하게 나뉘어 있다.@dnd-kit/abstract — 핵심 추상화. Modifier, Sensor, DragDropManager 등 모든 개념의 인터페이스가 여기 정의된다 @dnd-kit/dom — DOM 환경에 맞는 구체적 구현. PointerSensor, SnapToPointer 같은 실제 동작이 여기에 있다 @dnd-kit/react — React 바인딩중심에는 DragDropManager가 있다. Draggable/Droppable의 등록, 드래그 상태(DragOperation), 이벤트 발행, 충돌 감지까지 전부 이 매니저를 통해 흐른다. Sensor는 사용자 입력을 감지하는 역할이다. PointerSensor가 pointerdown 이벤트를 잡으면 manager.actions.setDragSource(id)를 호출해 드래그를 시작시킨다. 이후 포인터 이동마다 manager.actions.move(coordinates)로 위치를 업데이트한다. 핵심은 transform이 계산되는 방식이었다. DragOperation에는 이러한 getter가 있다. get transform() { const { x, y } = this.position.delta; let transform = { x, y }; for (const modifier of this.modifiers) { transform = modifier.apply({ ...this.snapshot(), transform }); } return transform; }포인터 이동량(position.delta)을 기반으로 transform을 만들고, 등록된 Modifier들이 순서대로 이 값을 변환한다. Modifier는 이 파이프라인에 끼어드는 레이어다. 각 Modifier의 apply() 메서드는 DragOperationSnapshot을 받는다. 여기에는 드래그 중인 요소의 초기/현재 bounding rectangle(shape), 드래그를 시작한 이벤트(activatorEvent), 현재 transform이 모두 담겨 있다. 이 정보를 조합하면 다양한 동작을 구현할 수 있다. 직접 구현할 때 어려웠던 이유가 보였다. 드래그 방향 판별, 시작 지점 추적, 이벤트 타이밍 처리 같은 것들을 전부 수동으로 관리했는데, dnd-kit은 이것들을 DragOperation 하나에 모아두고 추상화한 것이었다. 오픈소스 기여 - SnapToCenterCursor 오픈소스 기여를 해보고 싶다는 생각이 들었을 때, 자연스럽게 dnd-kit이 떠올랐다. 내부 구조를 어느 정도 파악하고 있었으니까. 이슈 트래커를 열어보니 #1863가 눈에 들어왔다. "드래그 시 아이템이 커서 중앙에 스냅됐으면 좋겠다"는 요청이었다. 기본적으로 dnd-kit는 클릭한 위치의 offset을 그대로 유지한다. 요소를 잡으면 해당 요소의 커서를 그대로 따라가는 식이다. 하지만 어디를 클릭하든 항상 요소의 중앙이 커서에 맞춰지는 동작이 필요한 경우가 있다. 드래그 오버레이를 쓸 때나, 카드처럼 크기 있는 요소를 자연스럽게 끌고 싶을 때가 대표적이다. SnapToPointer 구현 — 핵심 로직 처음 구현한 이름은 SnapCenterToCursor였다. 요소의 중앙이 커서에 붙도록 transform 값을 보정하는 modifier다. 핵심 로직은 세 단계다.드래그 시작 시점의 커서 위치를 activatorEvent.clientX / clientY로 읽는다 요소의 boundingRectangle에서 앵커 좌표(anchorX, anchorY)를 계산한다 현재 transform에 (커서 위치 - 앵커 좌표)의 차이를 더해 반환한다수식으로 쓰면 이렇다. const x = transform.x + activatorEvent.clientX - anchorX; const y = transform.y + activatorEvent.clientY - anchorY;직접 drag-drop을 구현할 때 씨름했던 바로 그 좌표 계산 영역이었다. 그때는 엣지케이스에 치여 버그를 잡지 못했는데, 이번엔 그 로직을 정돈된 형태로 볼 수 있었다. 메인테이너의 리뷰 PR을 올렸더니 리뷰어가 중요한 피드백을 남겼다. 중앙만 지원하면 너무 제한적이지 않냐, 다른 앵커 포인트도 지원하면 더 유용할 것 같다고.맞는 말이었다. 예를 들어 카드의 우측 상단에 커서를 두고 드래그하고 싶을 수도 있다. 그래서 anchor 옵션을 추가하기로 했다. type Anchor = | "center" | "top-left" | "top-right" | "bottom-left" | "bottom-right";export class SnapToPointer extends Modifier<DragDropManager, Options> { apply({ activatorEvent, shape, transform }: DragOperation) { if (!shape || !(activatorEvent instanceof PointerEvent)) { return transform; } const anchor = this.options?.anchor ?? "center"; const { boundingRectangle, center } = shape.initial; let anchorX: number; let anchorY: number; // anchor 처리 switch (anchor) { case "top-left": anchorX = boundingRectangle.left; anchorY = boundingRectangle.top; break; case "top-right": anchorX = boundingRectangle.right; anchorY = boundingRectangle.top; break; case "bottom-left": anchorX = boundingRectangle.left; anchorY = boundingRectangle.bottom; break; case "bottom-right": anchorX = boundingRectangle.right; anchorY = boundingRectangle.bottom; break; default: anchorX = center.x; anchorY = center.y; } // 이하 생략 } }enum 방식을 적용해서 직관적이고 자동완성도 되기 때문에 나쁘지 않게 구현했다고 생각했다. 그런데 두 번째 리뷰에서 또 피드백이 왔다.정리하면 percentage 방식으로 모델링하는 게 훨씬 좋다는 이야기다. 그렇게 되면 Anchor에서 정의한 내용뿐만 아니라 사용자가 원하는 위치에 snap을 적용할 수 있다. 훨씬 더 좋은 방식이라는 것에 동의하게 되었다. export class SnapToPointer extends Modifier<DragDropManager, Options> { apply({ activatorEvent, shape, transform }: DragOperation) { if (!shape || !(activatorEvent instanceof PointerEvent)) { return transform; } const anchor = this.options?.anchor ?? DEFAULT_ANCHOR; const { boundingRectangle } = shape.initial; const anchorX = boundingRectangle.left + boundingRectangle.width * anchor.x; const anchorY = boundingRectangle.top + boundingRectangle.height * anchor.y; return { x: transform.x + activatorEvent.clientX - anchorX, y: transform.y + activatorEvent.clientY - anchorY, }; } static configure = configurator(SnapToPointer); }드래그한 물체(boundingRectangle)의 width와 height에 anchor 값을 곱해 위치를 고정시켰다. 덕분에 코드 라인도 줄었고, 범용성 넓은 기능을 완성할 수 있었다. 코드 이외의 주변 작업 구현 코드 자체는 30줄 남짓이었지만, 머지까지 가는 데 주변 작업이 생각보다 많았다.DTS 빌드 에러 수정 — 명시적 반환 타입 추가 import 경로 수정 changeset 파일 추가 — 라이브러리의 버전 관리 체계를 파악해야 했다 문서 업데이트 — modifiers 레퍼런스에 SnapToPointer 내용 추가오픈소스 기여는 코드만이 아니다. 라이브러리의 규칙을 파악하고, 빌드 시스템을 이해하고, 문서를 맞추는 것까지 전부 포함된다. 마무리 PR [experimental] Add SnapToPointer modifier #2028이 머지됐다. 이번 기여에서 가장 인상적이었던 건 코드보다 설계 논의에 시간이 더 걸렸다는 점이다. 구현 자체는 하루 만에 끝났지만, "어떤 API가 더 나은가"를 리뷰어와 주고받는 데 훨씬 많은 에너지가 들었다. 혼자였다면 첫 번째 설계로 마무리했을 텐데, 리뷰 덕분에 더 유연한 방향으로 나아갈 수 있었다. 오픈소스 기여는 코드를 제출하는 게 아니라 함께 설계를 다듬는 과정이었다. 또 하나는, 직접 부딪혀본 경험이 이해의 깊이를 만든다는 것이다. BCSD에서 드래그를 직접 구현하며 겪은 어려움이 있었기에, dnd-kit이 왜 그 구조로 설계됐는지 더 빠르게 체감할 수 있었다. 라이브러리를 쓰기만 했다면 소스를 읽어도 와닿지 않았을 것이다. 잘 만들어진 추상화의 가치는, 직접 날것의 구현을 해본 사람일수록 더 깊이 느껴진다는 것을 알게 됐다.